AI Concept Library
科普库
所有概念按“算力、存力、运力、其他”归档。已经完成的页面可以直接进入,尚未制作的板块保持留白。
9 个已发布概念最近更新 · 2026.09
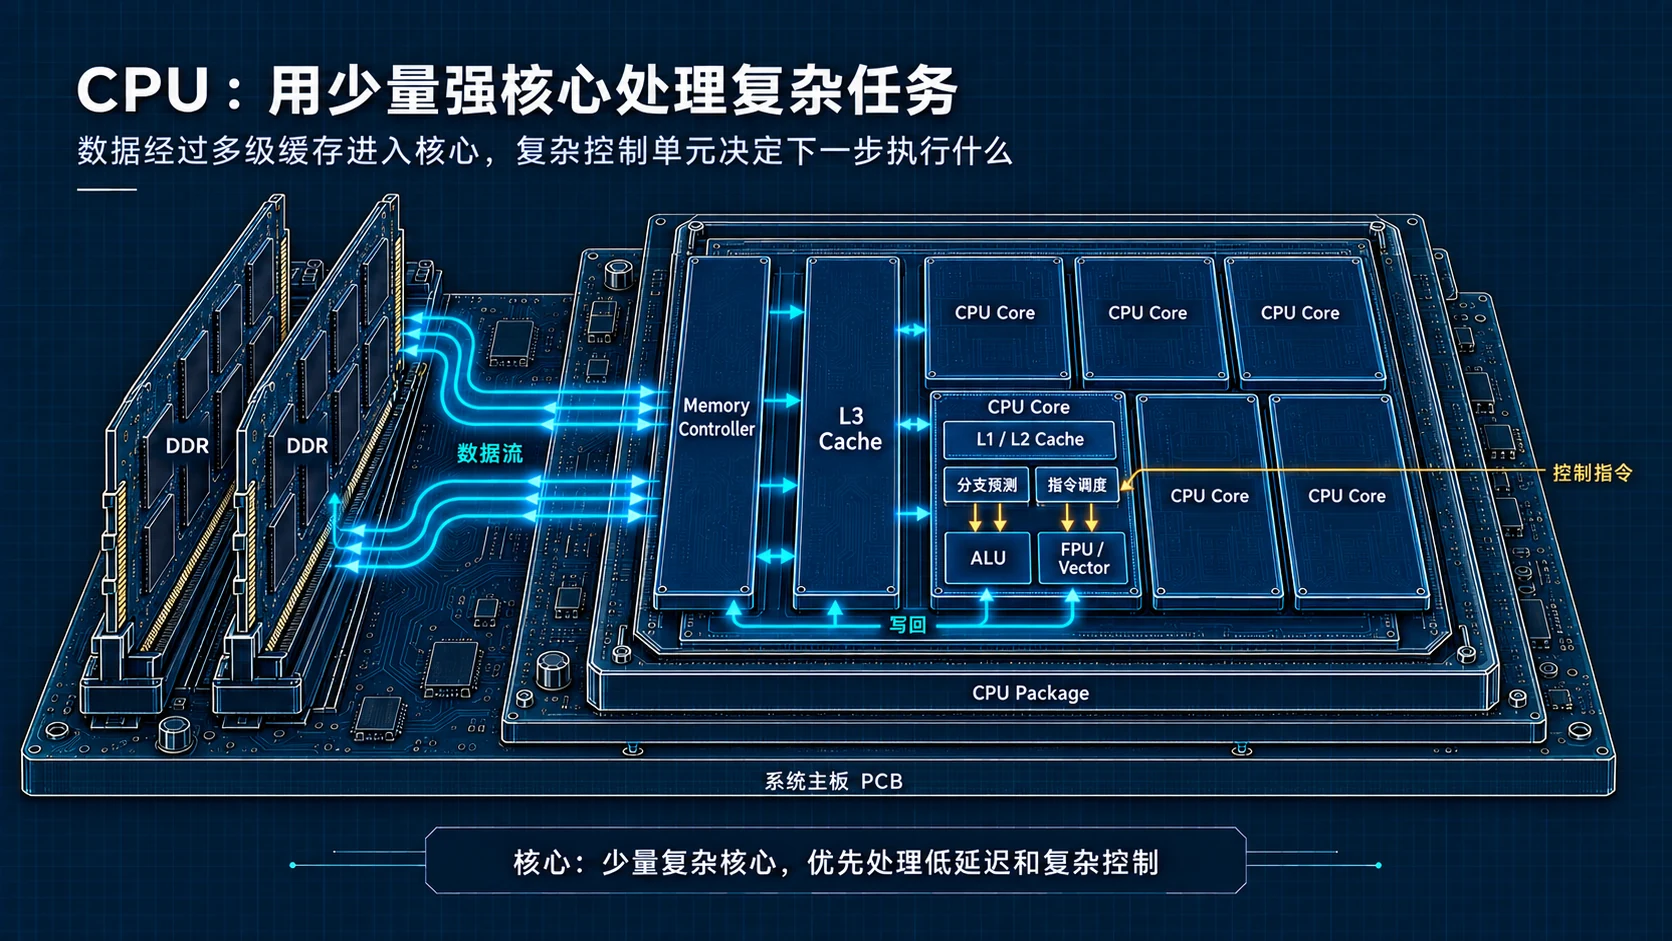
CPU 中央处理器
少量复杂核心、多级缓存与控制单元,优先处理低延迟和复杂逻辑。
DDRL3 CacheCPU CoreALU / FPU
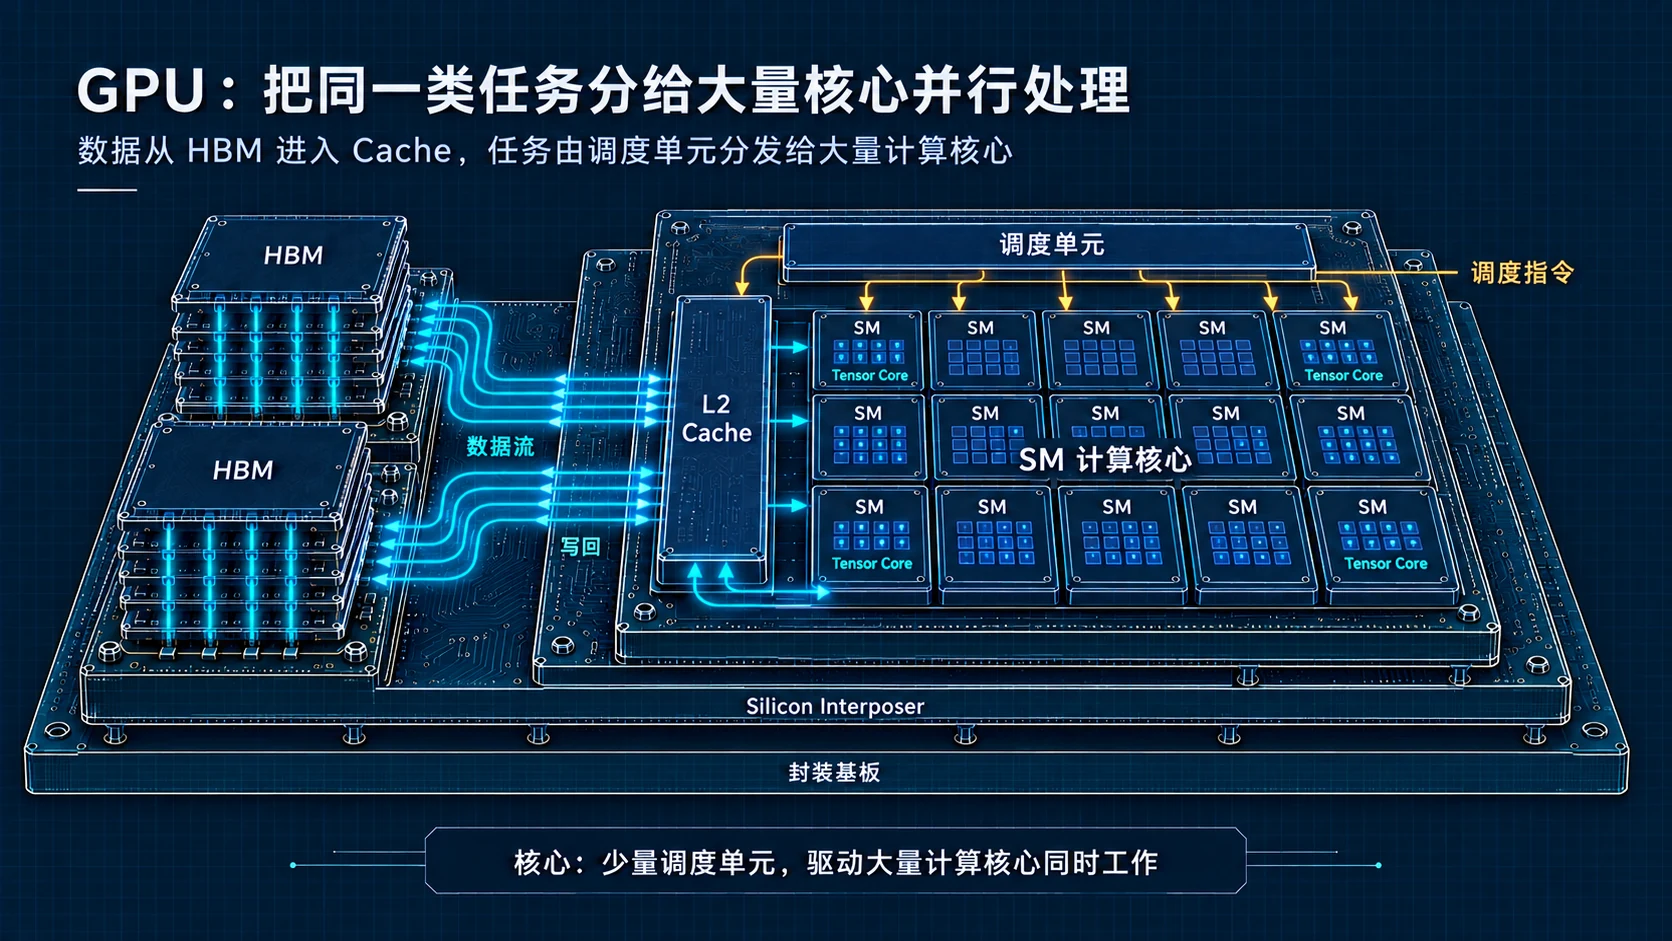
GPU 图形处理器
数据从 HBM 进入 Cache,调度单元将工作分给大量 SM 与 Tensor Core。
HBML2 CacheSchedulerSM
DRAM 动态随机存取存储器
先认识 DDR、LPDDR、GDDR、HBM,再比较 DDR3、DDR4 与 DDR5。
DDR3DDR4DDR5
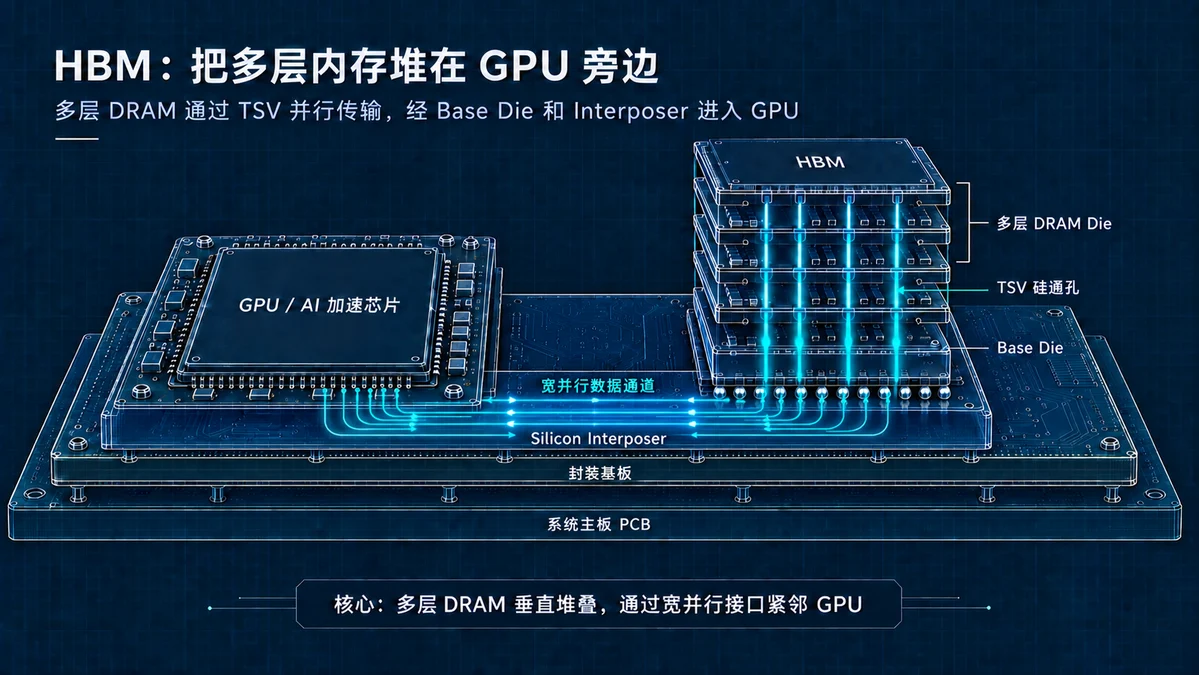
HBM 高带宽内存
多层 DRAM 垂直堆叠,通过 TSV 和 Interposer 内宽并行接口紧邻 GPU。
DRAMTSVInterposerGPU
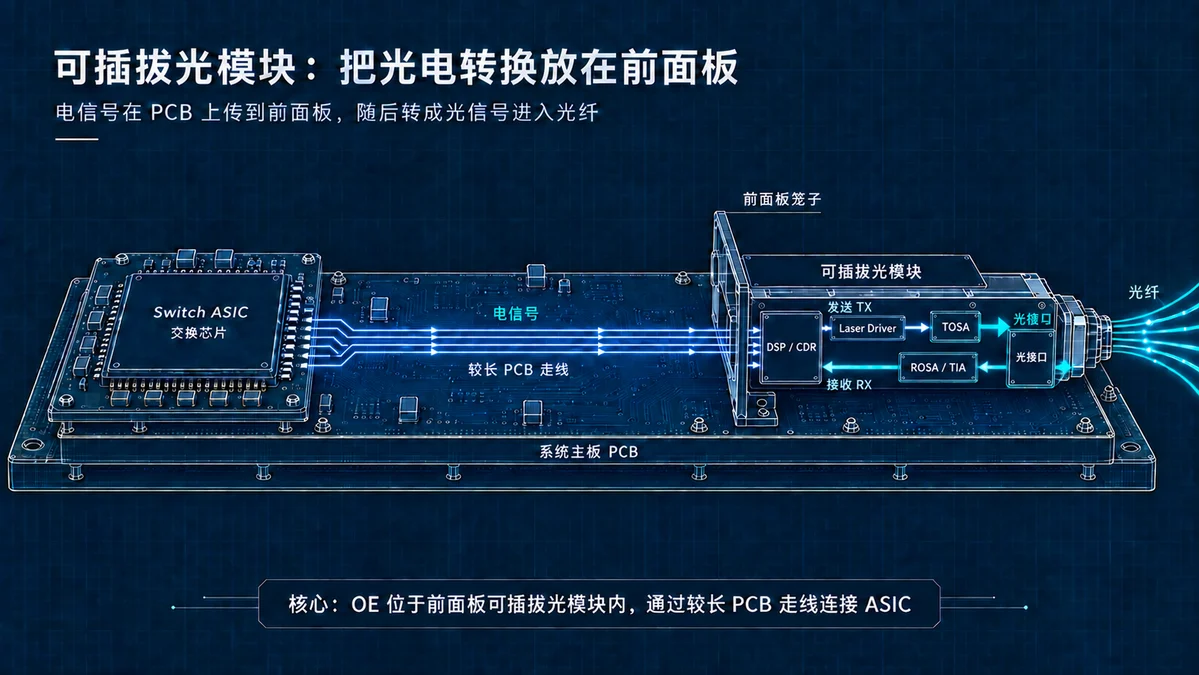
可插拔光模块 Pluggable Optics
OE 位于前面板模块内,通过较长 PCB 走线连接 Switch ASIC。
ASICPCBDSPTOSA/ROSA
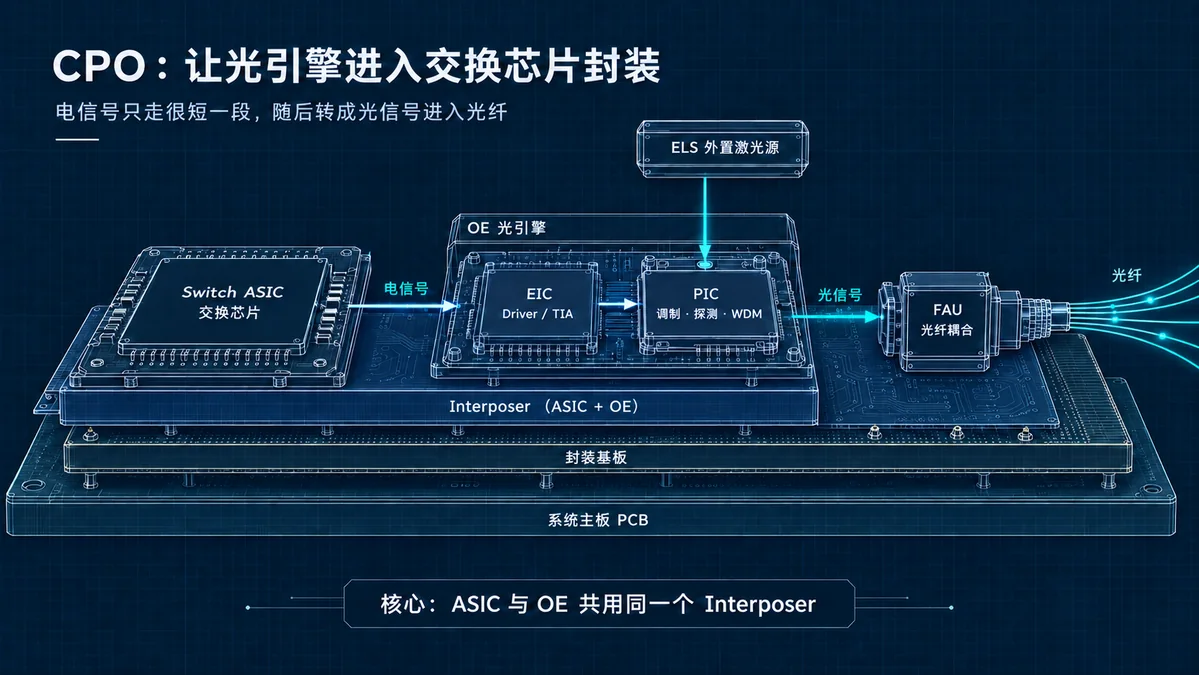
CPO 共封装光学
ASIC 与 OE 共用同一个 Interposer,让高速电信号更早进入光域。
ASICEICPICFAU
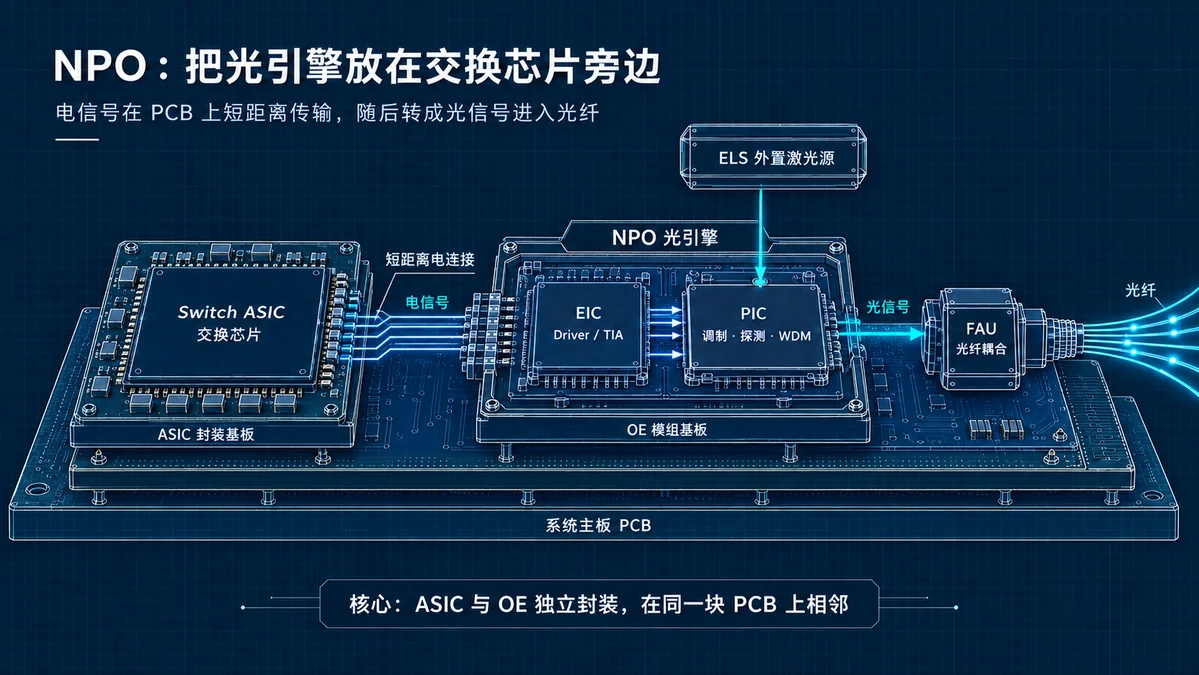
NPO 近封装光学
把独立光引擎放到 ASIC 旁边,缩短高速电信号经过的距离。
ASIC短电连接OE
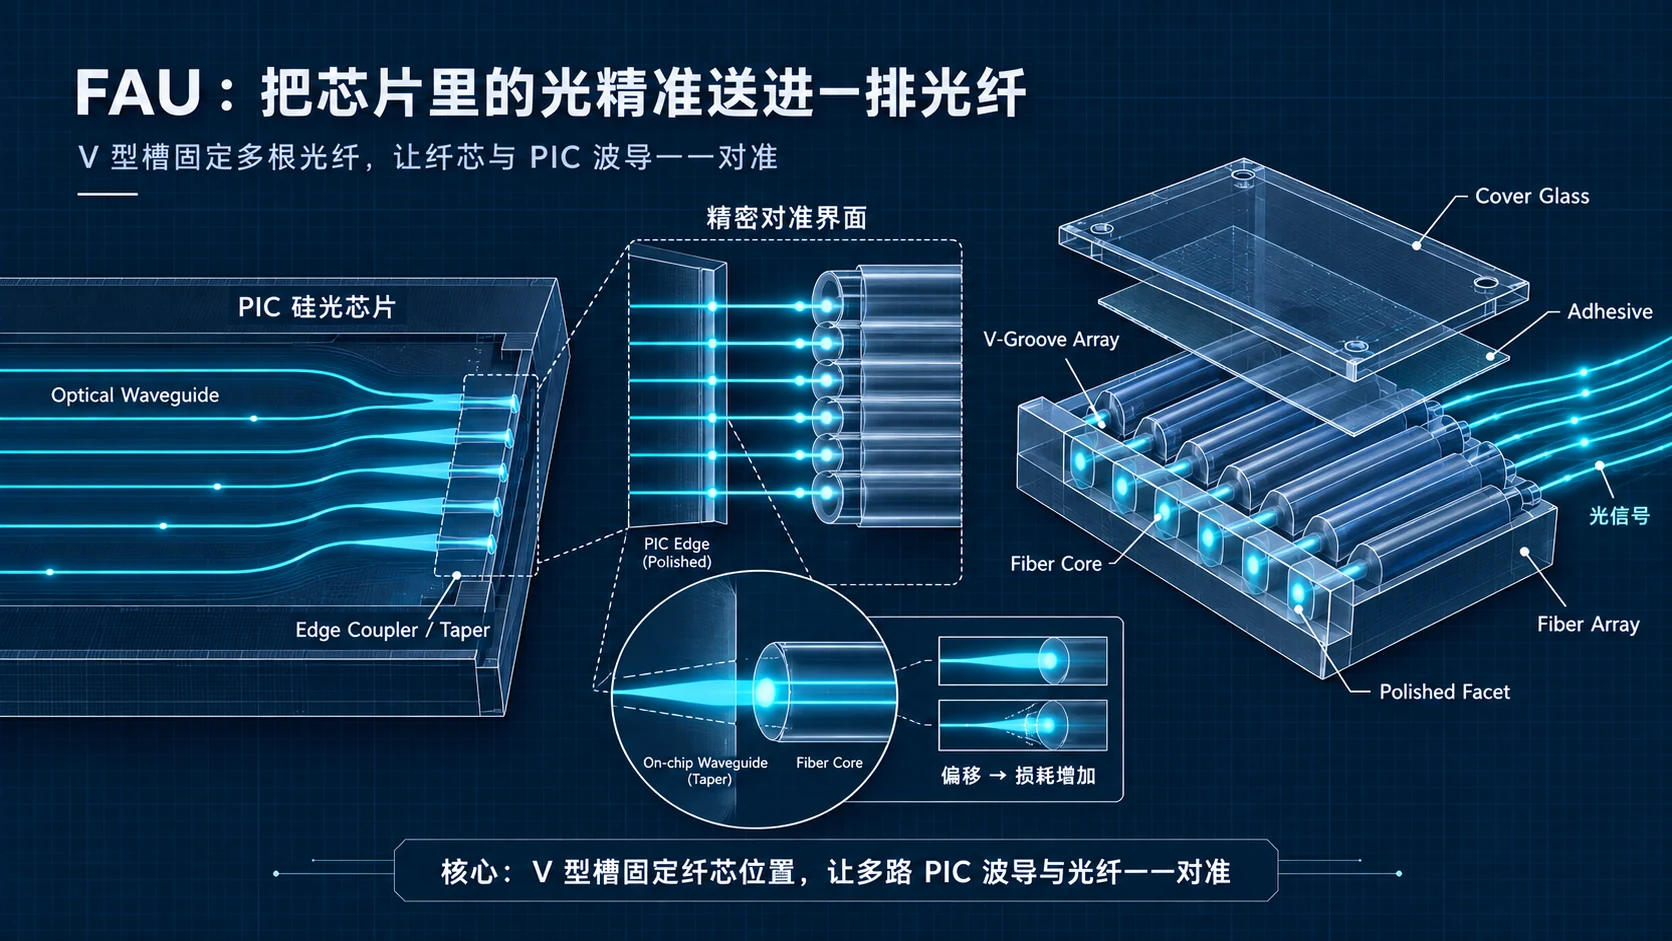
FAU 光纤阵列单元
用 V-Groove 固定多根光纤,让每个纤芯与 PIC 波导精密对准。
PICEdge CouplerFAUFiber
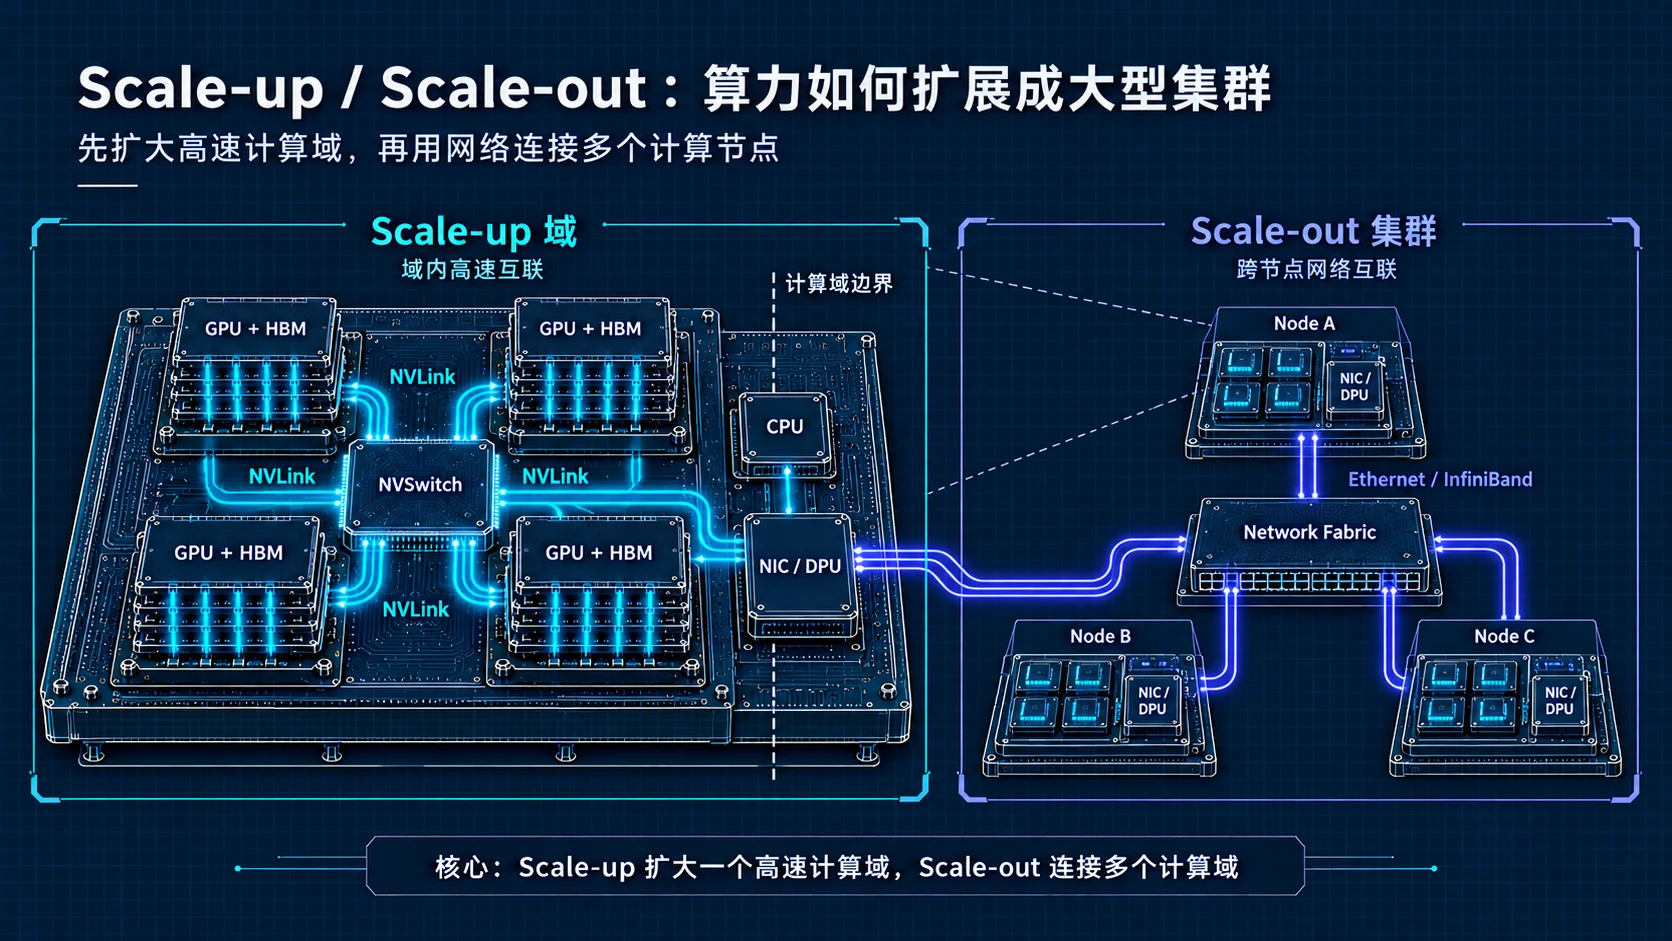
Scale-up / Scale-out 算力扩展
Scale-up 扩大一个高速计算域,Scale-out 通过网络连接多个计算域。
GPUNVSwitchNIC / DPUNetwork Fabric
运力 · 下一项NVLink概念页待制作
这个板块已经留好位置具体概念尚未制作,后续会逐步补充。