01
COMPUTE UNIT
GPU 与 HBM 组成基础计算单元
每颗 GPU 负责计算,附近的 HBM 保存当前工作数据。当单颗 GPU 不够用时,系统需要向外扩展。
 大奇科普库
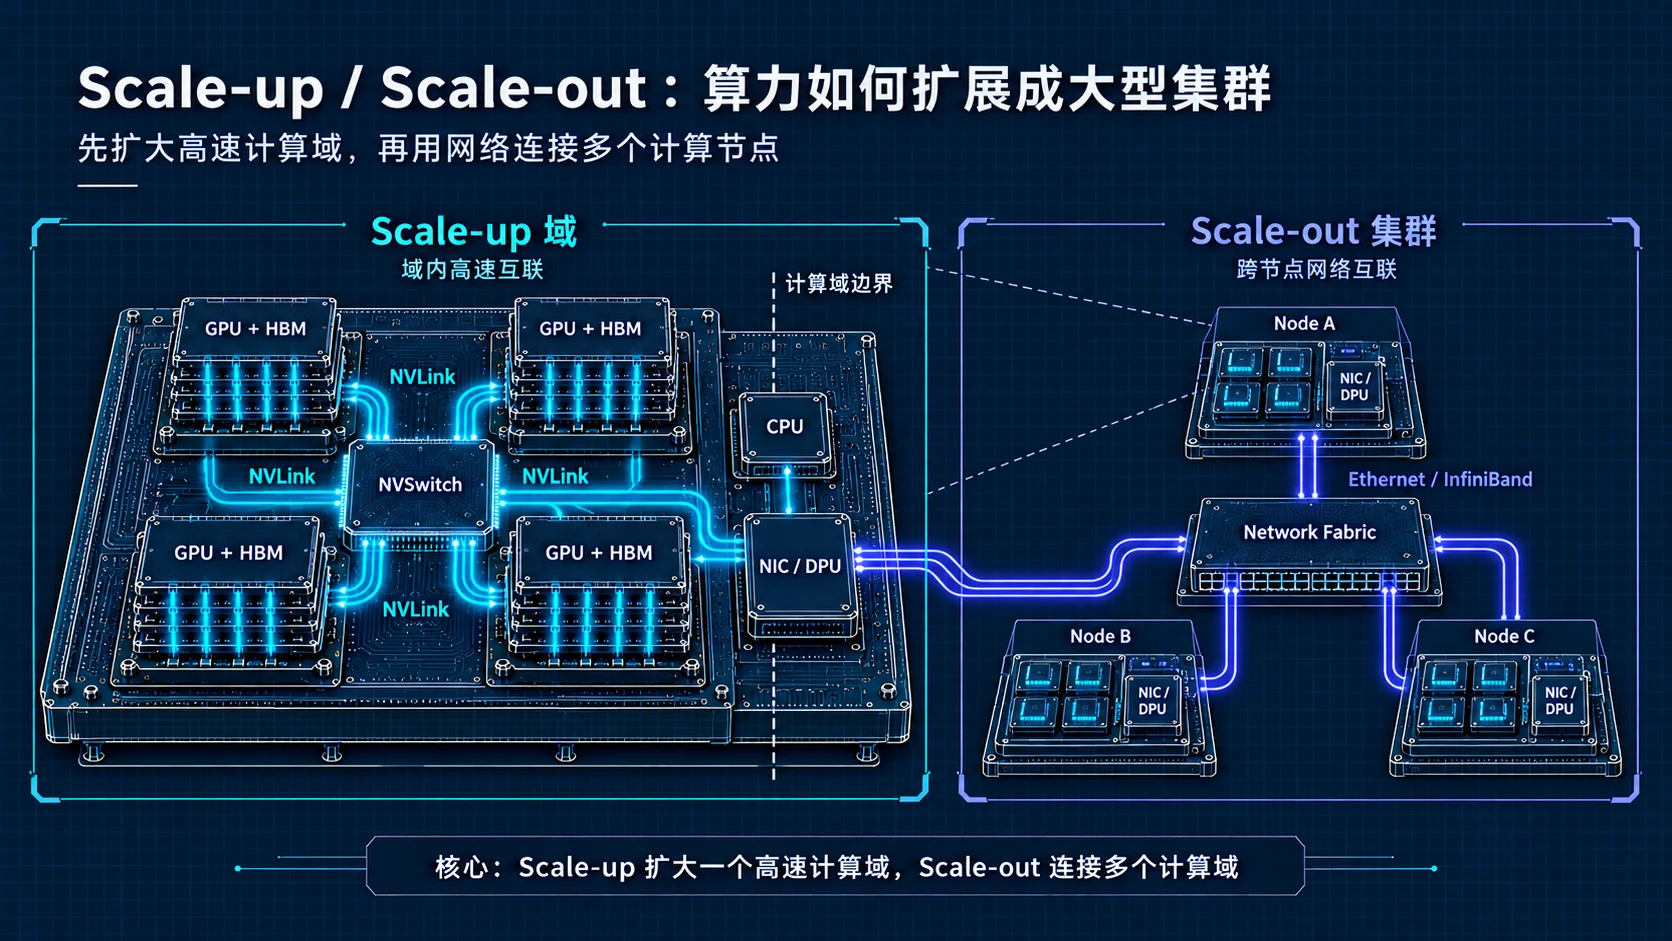
Scale-up 用高速互联扩大单个计算域;Scale-out 用网络连接多个计算节点。
每颗 GPU 负责计算,附近的 HBM 保存当前工作数据。当单颗 GPU 不够用时,系统需要向外扩展。
“盒子内与盒子间”是直观理解,真实边界由系统架构决定
Scale-up 更准确的边界是一个高速、紧密协同的计算域,而不是机箱外壳。具体实现可能覆盖计算托盘、机箱,也可能扩展到整个机柜。
跨节点通信需经过网卡、网络交换机和更长的传输路径,延迟、协议开销和同步成本都会增加。紧密耦合的计算更希望尽量留在 Scale-up 域内。
单个 Scale-up 域能容纳的 GPU 数量终究有限。系统先用 Scale-up 提高域内协同效率,再用 Scale-out 将多个高速计算域扩展成更大的训练或推理集群。